Points clés à retenir (TL;DR)
Synthèse exécutive- La gestion des incidents selon ITIL 4 a un seul objectif : rétablir le service le plus vite possible — pas forcément trouver la cause racine (ça, c'est la gestion des problèmes).
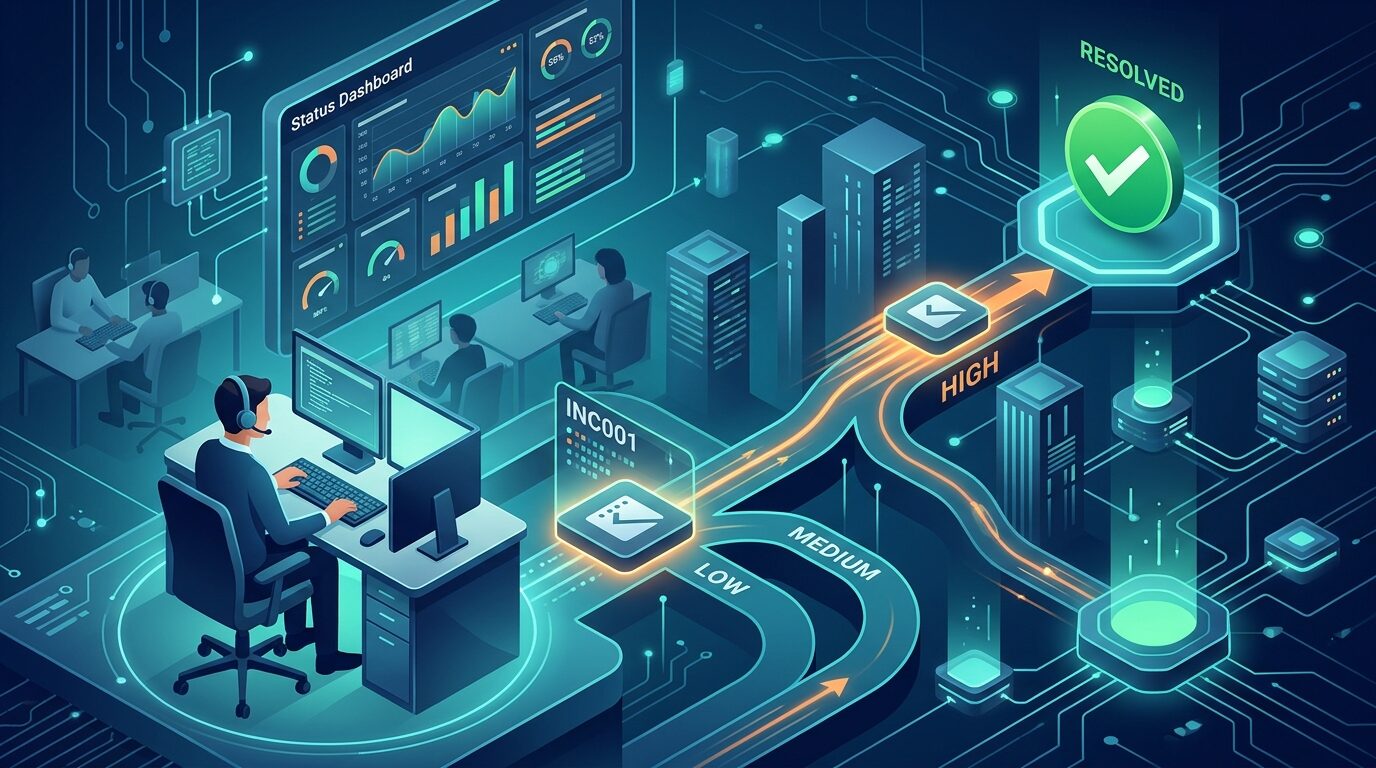
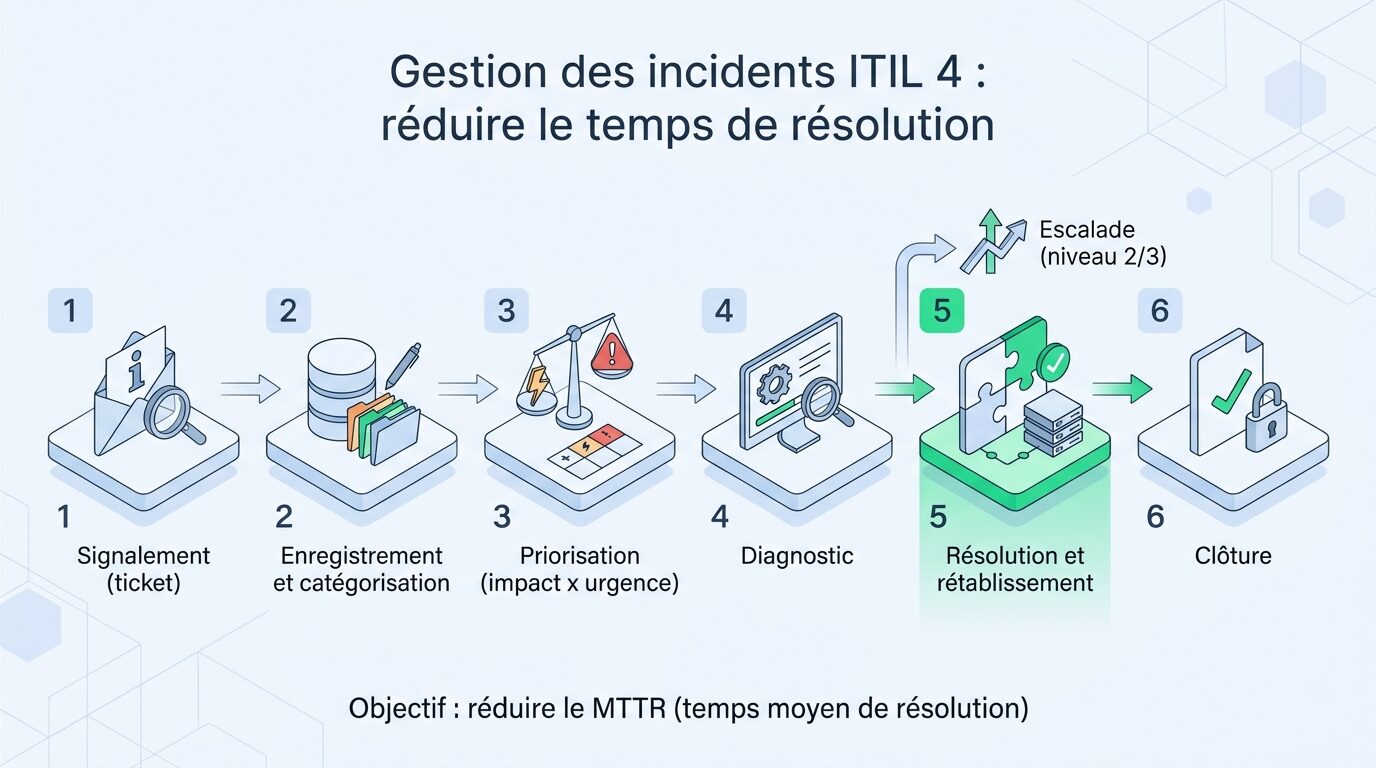
- Un incident bien pris en charge suit toujours les mêmes étapes : détection, enregistrement, catégorisation, priorisation, diagnostic, résolution, clôture.
- La priorité se calcule en croisant l'impact et l'urgence — pas selon qui crie le plus fort.
- Des modèles d'incident (procédures pré‑écrites pour les cas fréquents) font gagner un temps considérable et uniformisent la qualité.
- Ce qui se mesure s'améliore : temps de première réponse, temps de résolution, taux de résolution au premier niveau.
Contexte : pourquoi une méthode change tout
Dans une PME, « le réseau est lent » ou « je n’ai plus accès à ma boîte courriel » arrivent tous les jours. Sans méthode, ces demandes se traitent au feeling : la plus bruyante passe devant, certaines se perdent, et personne ne sait vraiment combien de temps on met à régler les choses. ITIL 4 — le cadre de référence de la gestion des services TI — propose une approche simple pour remettre de l’ordre, sans alourdir le quotidien. L’objectif n’est pas la paperasse : c’est de rétablir vite le service et d’apprendre de chaque incident.
Incident, demande, problème : ne pas confondre
Trois notions se mélangent souvent. Les distinguer change la façon de les traiter :
- Incident : une interruption non planifiée ou une dégradation d’un service (une application qui plante, une imprimante hors service).
- Demande de service : quelque chose de normal et planifiable (un nouvel accès, l’installation d’un logiciel, une réinitialisation de mot de passe).
- Problème : la cause sous‑jacente d’un ou plusieurs incidents, traitée à froid pour éviter qu’ils ne reviennent.
Un incident se gère dans l’urgence ; un problème se gère dans la durée. Les mélanger, c’est soit paralyser le service en cherchant la cause pendant que l’utilisateur attend, soit colmater sans jamais régler le fond.
Les 7 étapes d’un incident maîtrisé
- Détection — par un utilisateur, un technicien ou, idéalement, par la supervision avant même la plainte.
- Enregistrement — tout incident est consigné, même réglé en deux minutes. Ce qui n’est pas enregistré n’existe pas et ne se mesure pas.
- Catégorisation — on classe (poste, réseau, messagerie, application métier…) pour router vers la bonne équipe et analyser les tendances.
- Priorisation — impact × urgence (voir plus bas).
- Diagnostic — on s’appuie sur la base de connaissances et les incidents similaires déjà résolus.
- Résolution — on rétablit le service, puis on confirme avec l’utilisateur.
- Clôture — on documente la solution, qui alimente la base de connaissances et accélère le prochain cas identique.
Prioriser sans se tromper : impact et urgence
La priorité n’est pas « premier arrivé, premier servi ». On la calcule en croisant deux axes :
| Urgence forte | Urgence faible | |
|---|---|---|
| Impact large (un site, une équipe) | Priorité critique | Priorité moyenne |
| Impact limité (une personne) | Priorité moyenne | Priorité basse |
Une panne de messagerie touchant tout le bureau un lundi matin est critique. Une icône mal alignée sur un poste est basse, même si l’utilisateur insiste. Une grille de priorité affichée évite les débats et les passe‑droits.
Les modèles d’incident : votre meilleur levier de rapidité
80 % des tickets sont des variantes de quelques cas récurrents. Pour chacun, écrivez un modèle d’incident : les questions à poser, les vérifications à faire, les étapes de résolution. Résultat : un technicien junior traite un cas courant aussi bien qu’un senior, et personne ne réinvente la roue à chaque fois.
Mesurer pour progresser
Quelques indicateurs suffisent pour piloter un centre de services : temps de première réponse, temps de résolution moyen par priorité, taux de résolution au premier niveau, et respect des cibles de service. Ce qui se mesure s’améliore ; ce qui ne se mesure pas stagne.
À retenir
Pas besoin d’un projet de six mois. Trois gestes suffisent pour démarrer : enregistrer tous les incidents dans un seul outil, afficher une grille de priorité simple, et documenter les cinq cas les plus fréquents. Le reste viendra naturellement, et votre support gagnera en vitesse comme en sérénité.
Besoin de structurer votre centre de services et vos processus ITIL à la taille de votre organisation ? Parlez à WeITSM.