Points clés à retenir (TL;DR)
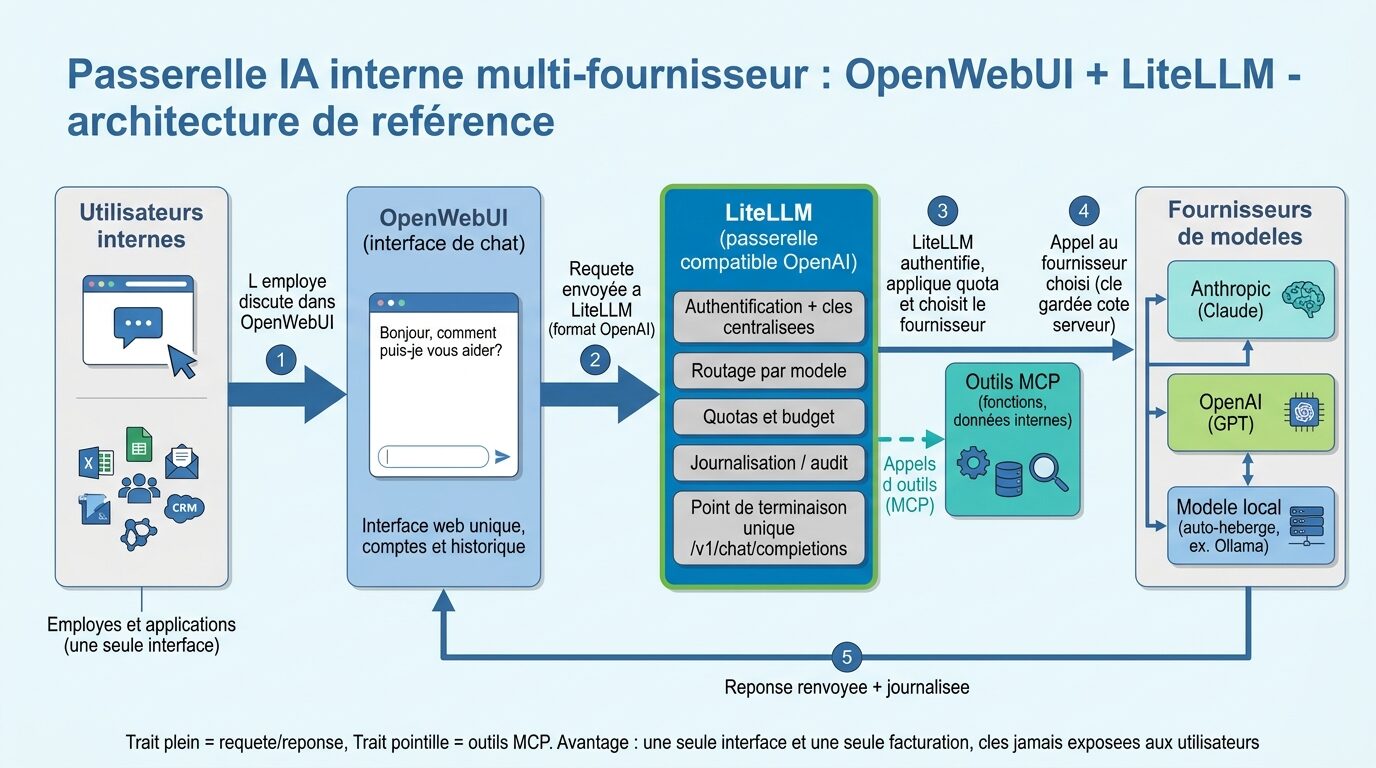
Synthèse exécutive- Une passerelle interne compatible OpenAI (LiteLLM) permet de router les requetes vers plusieurs modeles (locaux ou hebergés) via une seule API et une seule cle.
- OpenWebUI fournit une interface utilisateur centralisee, avec gestion des comptes et journalisation des usages.
- Un pont compatible OpenAI peut exposer un abonnement tiers comme une API standard, mais concentre un risque d'authentification a proteger strictement.
- Les points sensibles : fuite de donnees vers les fournisseurs, injection de prompt et dependance a des services externes.
- La securite repose sur l'isolement reseau, un reverse-proxy avec TLS et authentification, et une politique d'usage ecrite.
Contexte
De plus en plus de PME veulent offrir l’IA generative a leurs equipes sans multiplier les abonnements individuels ni disperser les donnees. Une passerelle IA interne resout ce probleme : une seule porte d’entree, compatible avec le standard OpenAI, derriere laquelle vous branchez plusieurs modeles (un modele local type Llama execute sur vos serveurs, ou des modeles hebergés chez un fournisseur).
Deux briques open source couvrent l’essentiel. LiteLLM joue le role de routeur : il expose un endpoint /v1/chat/completions identique a l’API OpenAI et redirige chaque appel vers le bon modele selon le nom demande. OpenWebUI fournit l’interface web (conversations, historique, comptes utilisateurs) et se branche sur LiteLLM comme sur n’importe quel backend OpenAI.
L’interet pour une PME est triple : maitrise des couts (une cle centralisee, des quotas), tracabilite (qui utilise quoi), et flexibilite (changer de modele sans toucher aux applications clientes, puisqu’elles parlent toutes le meme protocole).
Architecture minimale
Sur une machine Docker dediee, dans un VLAN interne non expose a Internet :
# docker-compose.yml (extrait generique)
services:
  litellm:
    image: ghcr.io/berriai/litellm:main-latest
    command: ["--config", "/app/config.yaml"]
    ports: ["4000:4000"]   # a n'exposer que sur le reseau interne
    volumes: ["./config.yaml:/app/config.yaml:ro"]
    environment:
      LITELLM_MASTER_KEY: "${LITELLM_MASTER_KEY}"
  openwebui:
    image: ghcr.io/open-webui/open-webui:main
    ports: ["3000:8080"]
    environment:
      OPENAI_API_BASE_URL: "http://litellm:4000/v1"
      OPENAI_API_KEY: "${LITELLM_MASTER_KEY}"
    depends_on: ["litellm"]
# config.yaml de LiteLLM (routage multi-modele)
model_list:
  - model_name: llama-local
    litellm_params:
      model: ollama/llama3.2:3b
      api_base: http://192.0.2.10:11434   # serveur modele local (exemple)
  - model_name: assistant-redaction
    litellm_params:
      model: openai/gpt-4o-mini
      api_key: os.environ/FOURNISSEUR_API_KEY
Cote applicatif, un client TypeScript se contente de pointer vers la passerelle, en reutilisant le format OpenAI avec streaming SSE :
const BASE = process.env.LLM_BASE_URL ?? 'http://192.0.2.20:4000'
const KEY  = process.env.LLM_API_KEY ?? ''

const res = await fetch(`${BASE}/v1/chat/completions`, {
  method: 'POST',
  headers: { 'Content-Type': 'application/json', Authorization: `Bearer ${KEY}` },
  body: JSON.stringify({ model: 'llama-local', messages, stream: true }),
})
Etape de validation
Verifiez que le routage repond avant de connecter l’interface :
curl -s http://192.0.2.20:4000/v1/models \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY"

curl -s http://192.0.2.20:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H 'Content-Type: application/json' \
  -d '{"model":"llama-local","messages":[{"role":"user","content":"dis OK"}]}'
La liste des modeles doit renvoyer vos noms exposes, et la completion doit retourner une reponse non vide. Dans ITIL, traitez cette mise en place comme un changement standard planifie en fenetre de maintenance, passe au CAB si l’exposition reseau le justifie.
Plan de retour
Conservez l’etat anterieur avant tout deploiement : docker compose down puis restauration de l’ancien config.yaml et des variables d’environnement. Les applications clientes gardant l’URL de l’ancien backend, un retour arriere consiste a repointer LLM_BASE_URL vers la configuration precedente et a redemarrer. Sauvegardez les volumes (comptes OpenWebUI, journaux) avant chaque changement.
Les risques
Fuite de donnees
Chaque requete routee vers un modele hebergé quitte votre perimetre. Sans cloisonnement, un utilisateur peut coller des donnees sensibles (contrats, donnees clients) qui transitent chez un tiers. Les modeles locaux limitent ce risque mais pas la journalisation excessive : les prompts stockes en clair deviennent eux-memes une cible.
Injection de prompt
Un contenu malveillant insere dans un document ou une page web analysee peut detourner le modele pour exfiltrer du contexte ou executer des actions non prevues (MITRE ATT&CK, abus de confiance applicative). Le risque augmente des que la passerelle est connectee a des outils ou connecteurs (type MCP) capables d’agir.
Dependances et authentification
Un pont qui expose un abonnement tiers comme une API repose souvent sur un jeton OAuth longue duree. Ce jeton equivaut a un acces complet a l’abonnement : s’il fuit, il est exploitable tel quel. De meme, un proxy qui n’impose pas de cle par defaut est une porte ouverte s’il est joignable depuis un reseau non maitrise.
Les controles
- Isolement reseau : ne publiez jamais les ports de la passerelle (4000, interface, ponts eventuels) directement sur Internet. Limitez-les au VLAN interne et filtrez au pare-feu.
- Reverse-proxy + TLS + authentification : placez un reverse-proxy (Traefik, Nginx) devant l’interface et la passerelle, avec certificat TLS et authentification (SSO interne ou acces conditionnel). Aucun service ne doit etre atteignable sans passer par cette couche.
- Cle maitresse obligatoire : definissez
LITELLM_MASTER_KEYet des cles par equipe avec quotas. N’exposez jamais un endpoint sans cle. - Gestion des secrets : jetons OAuth et cles fournisseurs dans un gestionnaire de secrets ou des variables d’environnement, jamais commis dans un depot. Rotation reguliere et revocation immediate en cas de doute.
- Journalisation maitrisee : journalisez l’usage (qui, quel modele, quand) mais evitez de stocker les prompts complets en clair; appliquez une retention courte.
- Persistance sauvegardee : si la session d’un pont vit dans un volume, sauvegardez-le et protegez-le au meme titre qu’un coffre de secrets.
Bonnes pratiques
Politique d’usage
Redigez une courte charte : quelles donnees peuvent etre soumises a un modele local, lesquelles sont interdites pour un modele hebergé, qui valide l’ajout d’un nouveau fournisseur. Associez chaque modele expose a un niveau de sensibilite (par exemple, llama-local pour les donnees internes, un modele hebergé uniquement pour du contenu public).
Formation et accompagnement
Sensibilisez les equipes a l’injection de prompt et au risque de coller des donnees confidentielles. Un rappel simple dans l’interface et une session de 30 minutes suffisent souvent a reduire les mauvais usages. Nommez un referent IA charge de revoir les journaux et de maintenir la liste des modeles.
Gestion du changement
Tout ajout de modele ou de connecteur passe par la gestion des changements : evaluation du risque, fenetre de maintenance, etape de validation et plan de retour documentes. Les incidents (fuite suspectee, jeton compromis) suivent la gestion des incidents, avec revocation immediate des cles concernees.
A retenir
Une passerelle IA interne compatible OpenAI apporte a une PME la centralisation, la tracabilite et la flexibilite, sans enfermer les applications dans un seul fournisseur. Le facteur decisif n’est pas technique mais organisationnel : isolement reseau, gestion rigoureuse des secrets et politique d’usage claire. Commencez petit, validez chaque brique avec les commandes ci-dessus, et formalisez vos controles avant d’ouvrir l’acces aux equipes.
Vous evaluez une passerelle IA pour votre organisation ? Cadrez d’abord les niveaux de sensibilite de vos donnees et le modele d’exposition reseau avant tout deploiement.


