Points clés à retenir (TL;DR)
Synthèse exécutive- Un plan de reprise après sinistre (PRA/DR) repose sur deux objectifs mesurables : le RTO (temps de rétablissement) et le RPO (perte de données tolérée).
- Commencez par un inventaire des actifs critiques et une analyse d'impact, pas par l'achat d'outils.
- Appliquez la règle 3-2-1-1 pour les sauvegardes, avec au moins une copie hors ligne ou immuable.
- Un plan non testé n'est pas un plan : planifiez des exercices de restauration réguliers.
- Documentez les procédures et les rôles pour que la reprise ne dépende pas d'une seule personne.
Contexte
Pour une PME, une interruption prolongée des systèmes peut entraîner des pertes financières, des bris de contrat et une atteinte à la réputation. Les causes sont variées : panne matérielle, erreur humaine, défaillance d’un fournisseur infonuagique, dégât matériel (incendie, inondation) ou cyberattaque, notamment par rançongiciel (MITRE ATT&CK T1486 — Data Encrypted for Impact).
Beaucoup d’organisations croient à tort qu’« être dans le nuage » équivaut à être protégé. En réalité, la plupart des fournisseurs appliquent un modèle de responsabilité partagée : ils garantissent la disponibilité de la plateforme, mais la protection de vos données et leur restauration restent souvent de votre ressort. Un plan de reprise clair comble cet écart sans exiger un budget d’entreprise.
Comment ça marche
RTO et RPO : les deux chiffres qui comptent
Avant toute solution technique, définissez deux cibles par application ou service :
- RTO (Recovery Time Objective) : combien de temps pouvez-vous rester hors service ? Ex. : 4 heures pour la messagerie, 1 heure pour la facturation.
- RPO (Recovery Point Objective) : combien de données pouvez-vous vous permettre de perdre ? Ex. : 15 minutes de transactions, ou 24 heures de documents bureautiques.
Plus ces cibles sont basses, plus le coût et la complexité augmentent. L’objectif est de les aligner sur la réalité du métier, pas sur un idéal.
PRA, PCA et sauvegarde : ne pas confondre
- Sauvegarde : copies de données récupérables.
- Plan de reprise après sinistre (PRA) : procédures pour rétablir les systèmes TI après un incident majeur.
- Plan de continuité des activités (PCA) : vue plus large incluant personnel, locaux et processus métier.
La règle 3-2-1-1
Une référence éprouvée pour les sauvegardes :
- 3 copies des données,
- sur 2 supports différents,
- dont 1 hors site (ex. : stockage objet infonuagique),
- et 1 copie immuable ou hors ligne, protégée contre la suppression et le chiffrement par un attaquant.
Mise en oeuvre
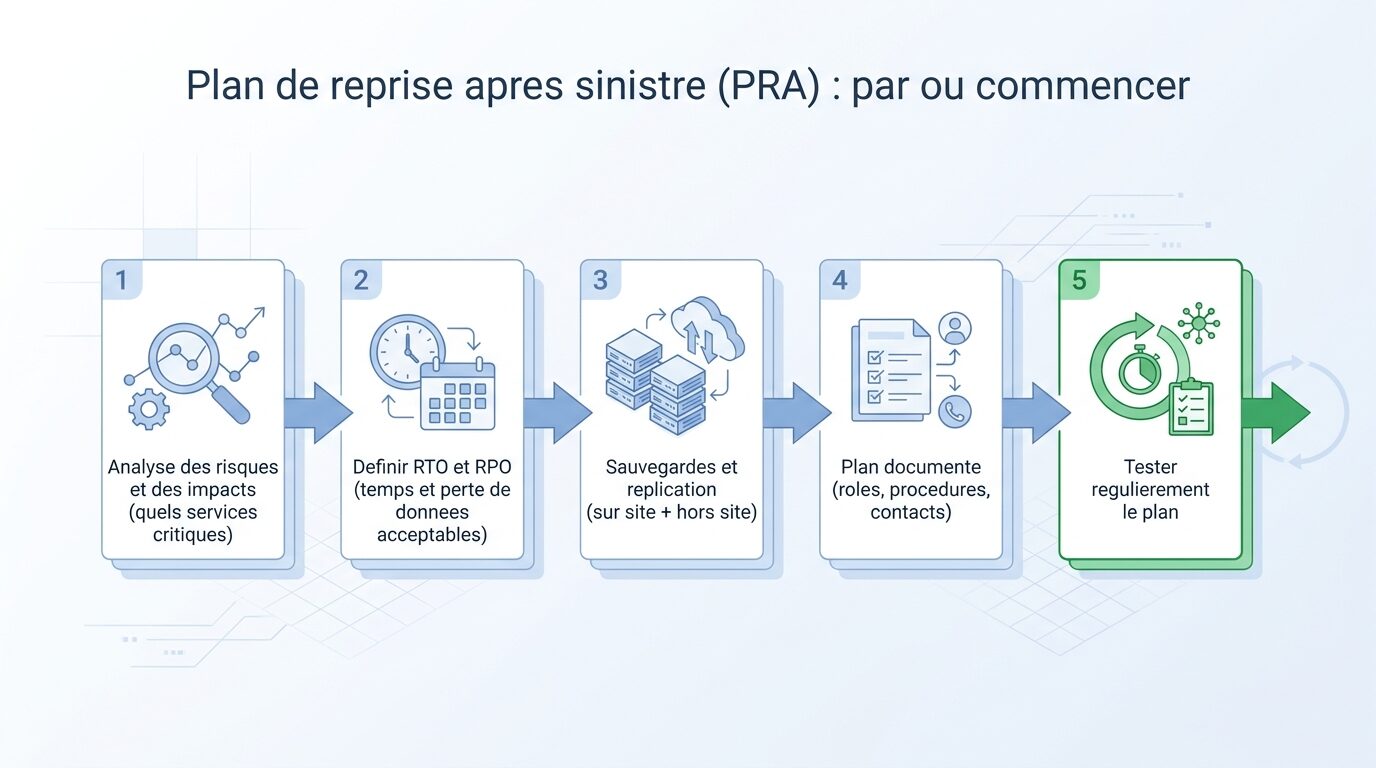
1. Inventaire et analyse d’impact
Listez les systèmes, applications et données. Classez-les par criticité et associez à chacun un RTO et un RPO réalistes.
| Service | Criticité | RTO | RPO |
|---|---|---|---|
| Facturation / ERP | Élevée | 1 h | 15 min |
| Messagerie | Moyenne | 4 h | 1 h |
| Partage de fichiers | Moyenne | 8 h | 24 h |
| Site vitrine | Faible | 24 h | 24 h |
2. Choisir la stratégie de reprise
Adaptez l’investissement à la criticité :
- Sauvegarde et restauration : la plus économique, RTO de quelques heures à une journée.
- Pilot light : une version minimale de l’environnement est prête à être démarrée.
- Warm standby : un environnement réduit tourne en permanence et monte en charge au besoin.
- Actif-actif / multi-sites : coûteux, réservé aux services où toute interruption est inacceptable.
3. Mettre en place les sauvegardes
Automatisez, chiffrez et vérifiez. Exemple de logique de rétention (pseudo-planification) :
Sauvegarde quotidienne  -> conservation 14 jours
Sauvegarde hebdomadaire -> conservation 8 semaines
Sauvegarde mensuelle    -> conservation 12 mois
Copie immuable (WORM)   -> verrou 30 jours minimum
Chiffrement             -> AES-256 au repos + en transit
Pour le stockage objet, activez le verrouillage d’objet (object lock / immutabilité) et l’authentification multifacteur sur les actions de suppression.
4. Documenter le plan
Rédigez un runbook clair : qui fait quoi, dans quel ordre, avec quels accès. Incluez les coordonnées, les procédures de restauration pas à pas et une copie hors ligne du plan (un incident peut rendre vos systèmes inaccessibles).
5. Tester régulièrement
Planifiez au moins deux exercices par an : restauration réelle d’un échantillon, puis simulation d’un sinistre complet. Mesurez le RTO et le RPO réels et corrigez les écarts.
Bonnes pratiques et risques
| Bonne pratique | Risque évité |
|---|---|
| Copie immuable ou hors ligne | Suppression des sauvegardes par un rançongiciel |
| Tests de restauration périodiques | Sauvegardes corrompues découvertes trop tard |
| Chiffrement et gestion des clés | Fuite de données lors d’un vol de support |
| Documentation hors ligne du plan | Plan inaccessible pendant l’incident |
| Accès à moindre privilège aux sauvegardes | Compromission d’un compte d’administration |
| Surveillance des coûts infonuagiques | Dérive budgétaire (stockage, sortie de données) |
Pièges fréquents :
- Confondre réplication et sauvegarde : une réplication copie aussi les données corrompues ou chiffrées par un attaquant.
- Oublier les données SaaS (messagerie, suites bureautiques, CRM) couvertes par un modèle de responsabilité partagée.
- Négliger les frais de sortie (egress) lors d’une restauration massive depuis le nuage.
- Stocker les identifiants de reprise dans le même système que celui à restaurer.
À retenir
Un plan de reprise après sinistre efficace ne commence pas par un achat, mais par des décisions métier : quels services sont critiques, et quels RTO/RPO sont acceptables. À partir de là, choisissez des sauvegardes 3-2-1-1 avec au moins une copie immuable, documentez les procédures et testez régulièrement.
Prochaine étape concrète : dressez cette semaine l’inventaire de vos systèmes critiques et fixez un RTO/RPO pour chacun. Ce simple tableau est la fondation de tout le reste. Au besoin, faites-vous accompagner pour valider la stratégie et exécuter un premier exercice de restauration.