Points clés à retenir (TL;DR)
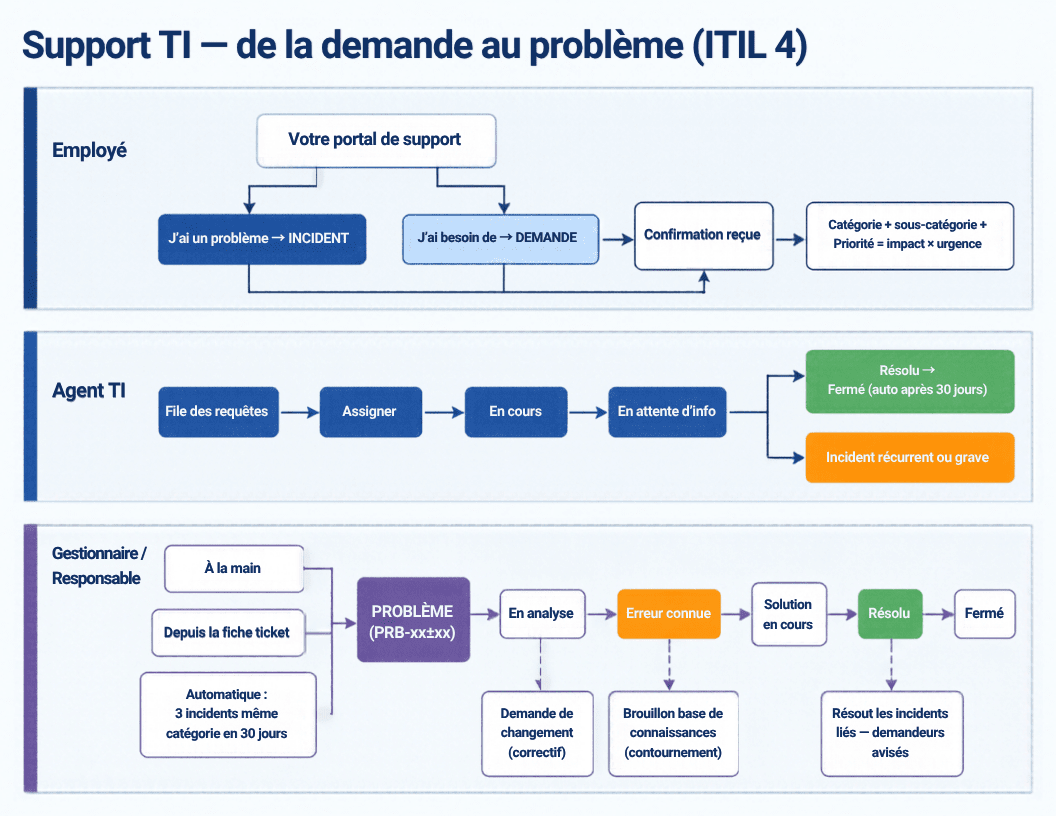
Synthèse exécutive- Classifiez dès l'enregistrement : un incident (service dégradé/interrompu), une demande de service (requête standard et planifiée) et un problème (cause racine d'incidents) suivent des flux distincts.
- Reliez chaque ticket à un article de la base de connaissances (KB) : une solution de contournement documentée réduit le temps de résolution des incidents récurrents.
- Formalisez la priorité par la matrice impact × urgence et respectez des cibles SLA mesurables (délai de réponse et de résolution).
- Escaladez un problème vers la gestion des changements (CAB) pour toute correction nécessitant une modification de l'environnement de production.
- Pilotez le support avec un petit jeu de KPI stables (taux de résolution au premier contact, respect SLA, backlog) plutôt qu'une dizaine d'indicateurs instables.
Contexte
Dans une PME, l’équipe TI absorbe souvent dans la même boîte courriel les mots de passe oubliés, les pannes d’imprimante, les demandes d’accès et les coupures applicatives. Sans distinction claire, tout devient « urgent », les mêmes incidents reviennent chaque semaine et aucune connaissance ne se capitalise. Le résultat : des techniciens qui éteignent des feux, des utilisateurs frustrés et aucune visibilité sur ce qui coûte réellement du temps.
ITIL 4 propose un langage commun et trois flux de travail complémentaires. L’objectif n’est pas la bureaucratie, mais de router chaque sollicitation vers le bon processus, de restaurer le service rapidement, puis d’éliminer les causes récurrentes. Pour une PME, c’est la différence entre un support réactif coûteux et un support maîtrisé qui s’améliore.
La methode etape par etape
Vocabulaire ITIL 4 utile : la gestion des incidents vise à restaurer le service normal le plus vite possible ; la gestion des demandes de service traite les requêtes prévisibles et à faible risque ; la gestion des problèmes cherche et élimine les causes racines ; la gestion des changements (avec le CAB, Change Advisory Board) encadre les modifications ; la gestion des connaissances capitalise les solutions.
1. Signalement et enregistrement
Centralisez tous les canaux (courriel, portail, téléphone) dans un seul outil de billetterie. Chaque ticket doit capturer : identité du demandeur, service touché, description, date/heure et canal. Objectif : zéro sollicitation hors outil.
2. Classification et catégorisation
Qualifiez le type à l’enregistrement :
- Incident : « l’application de facturation est inaccessible ».
- Demande de service : « créer un compte pour un nouvel employé ».
- Problème : « 5 incidents de lenteur réseau cette semaine au même étage ».
3. Priorisation (impact × urgence)
Déterminez la priorité de façon reproductible :
| Impact \ Urgence | Haute | Moyenne | Basse |
|---|---|---|---|
| Élevé (plusieurs services) | P1 | P2 | P3 |
| Moyen (une équipe) | P2 | P3 | P4 |
| Faible (un utilisateur) | P3 | P4 | P4 |
4. Diagnostic et solution de contournement
Pour un incident, cherchez d’abord un article de contournement (workaround) dans la KB. Documentez vos vérifications. Exemple de diagnostic pour un service Linux hypothétique « app-facturation » :
# Prerequis : acces SSH + droits sudo sur le serveur applicatif
systemctl status app-facturation
journalctl -u app-facturation --since "1 hour ago" --no-pager
ss -ltnp | grep ':8080'        # le service ecoute-t-il ?
curl -sS -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8080/health
5. Résolution et restauration
Appliquez la correction minimale qui restaure le service. Pour un service bloqué :
# Prerequis : fenetre de redemarrage acceptee par le proprietaire du service
sudo systemctl restart app-facturation
# ETAPE DE VALIDATION : confirmer le retour a la normale
systemctl is-active app-facturation            # attendu : active
curl -sS -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8080/health  # attendu : 200
PLAN DE RETOUR (rollback) : si le redémarrage aggrave la situation (le service ne revient pas en active ou le code HTTP reste différent de 200), revenez à l’état antérieur et escaladez :
# Revenir a la version precedente si un changement de config/binaire a ete tente
sudo cp /etc/app-facturation/config.conf.bak /etc/app-facturation/config.conf
sudo systemctl restart app-facturation
# Si echec, basculer le trafic vers l'instance de secours et escalader en P1
# puis consigner l'action dans le ticket (horodatage + resultat)
6. Clôture et traitement d’une demande de service
Une demande suit un flux standardisé (modèle de requête, approbation si requis, exécution, validation utilisateur). Exemple de création d’accès :
# Prerequis : approbation du gestionnaire enregistree dans le ticket
sudo useradd -m -s /bin/bash -c "Nouvel employe" jdoe
sudo usermod -aG facturation jdoe
# ETAPE DE VALIDATION
id jdoe                         # verifier les groupes attendus
# PLAN DE RETOUR
sudo userdel -r jdoe           # si la demande est annulee/erronee
7. De l’incident au problème, puis au changement
Quand des incidents se répètent, ouvrez un problème. Identifiez la cause racine (analyse des 5 pourquoi, corrélation des journaux). La correction durable passe souvent par un changement soumis au CAB, avec fenêtre de maintenance, évaluation du risque et plan de retour documenté. Appliquez les correctifs en vérifiant les versions dans l’avis officiel de l’éditeur ; ne présumez pas d’un numéro de CVE ni d’une version corrigée.
8. Capitalisation dans la base de connaissances
Toute résolution non triviale produit un article KB (symptômes, diagnostic, solution, contournement). C’est ce qui alimente le taux de résolution au premier contact et accélère le niveau 1.
Bonnes pratiques
- Un seul point d’entrée : refusez poliment les demandes « de couloir » et redirigez vers le portail.
- Modèles de tickets par catégorie : champs obligatoires = diagnostic plus rapide.
- Séparez « restaurer » (incident) de « corriger définitivement » (problème) : ne bloquez jamais un utilisateur en attendant la cause racine.
- Rédigez l’article KB pendant la résolution, pas « plus tard » (il ne sera jamais écrit).
- Faites passer tout changement de production par un enregistrement de changement, même léger, avec plan de retour.
Erreurs a eviter
- Tout traiter comme un incident urgent : la priorisation perd son sens.
- Fermer un ticket sans validation utilisateur ni article KB.
- Confondre contournement et correction : un redémarrage quotidien n’est pas une solution.
- Ne jamais ouvrir de problème : les mêmes incidents reviennent indéfiniment.
- Modifier la production sans fenêtre de maintenance ni plan de retour.
- Multiplier les KPI : trop d’indicateurs tuent le pilotage.
Indicateurs a suivre
| KPI | Définition | Pourquoi |
|---|---|---|
| Résolution au premier contact (FCR) | % d’incidents résolus au niveau 1 | Efficacité du N1 et de la KB |
| Respect des SLA | % de tickets dans les cibles de réponse/résolution | Qualité de service perçue |
| Délai moyen de résolution (MTTR) | Temps moyen de restauration | Rapidité opérationnelle |
| Backlog | Tickets ouverts hors cible | Charge et dérive |
| Incidents récurrents | Nombre liés à un même problème | Déclenche la gestion des problèmes |
| Taux de réouverture | % de tickets rouverts après clôture | Qualité réelle des résolutions |
A retenir
Trois flux, un même objectif : restaurer vite (incident), servir efficacement (demande) et éliminer durablement (problème), en capitalisant chaque solution dans la base de connaissances. La discipline de classification et un petit jeu de KPI stables transforment un support réactif en service maîtrisé.
Prochaine étape concrète : auditez vos 30 derniers tickets, classez-les en incident / demande / problème, et identifiez le premier article KB à rédiger. Pour structurer vos flux ITIL 4, l’équipe WeITSM peut vous accompagner.